Введение
Python прочно занял место одного из основных языков серверной разработки, в том числе для сервисов на асинхронных веб-фреймворках, таких как FastAPI. Вокруг языка сложился и развитый набор средств контроля качества кода. Подсказки типов, стандартизированные в PEP 484, проверяет статический анализатор mypy [11]; нарушения стиля и типовые логические ошибки находит линтер ruff [12]; неиспользуемый код выявляет vulture [14]; распространенные небезопасные конструкции обнаруживает bandit [5]. Поведение кода контролируют автотесты на pytest с измерением покрытия.
Однако наличие инструментов еще не означает, что они влияют на качество. Во многих командах проверки запускаются в рекомендательном режиме, и качество кода определяется дисциплиной разработчика и внимательностью ревьюера. По результатам интервью, проведенных Б. Джонсоном и соавторами, главными препятствиями к использованию статического анализа служат ложные срабатывания и неудобный способ подачи предупреждений [9, с. 672]. К. Садовски и соавторы, обобщив опыт Google, показали, что разработчики игнорируют предупреждения вне основного рабочего процесса, а проверки с низкой долей ложных срабатываний, встроенные в сборку и рецензирование кода, действительно меняют их поведение [13].
Польза отдельных проверок подтверждается и количественно. Ф. Хан и соавторы изучили историю исправленных дефектов в 210 открытых Python-проектах и установили, что 15% из них могли быть обнаружены проверкой типов mypy еще до выпуска. Среди основных причин таких ошибок авторы называют переопределение ссылок, динамическую инициализацию атрибутов и неверную обработку значения None [10, с. 3145].
В микросервисной архитектуре проблема обостряется: код распределен по десяткам репозиториев, и требования к качеству со временем расходятся. Отложенные исправления накапливаются в виде технического долга, по которому, по выражению У. Каннингема, продолжают начисляться «проценты» в виде лишних затрат на работу с неудачным кодом [6]. Д. Хамбл и Д. Фарли предложили решать такие задачи на уровне процесса: в конвейере развертывания каждое изменение проходит автоматические стадии проверки, и неудача на любой из них останавливает его продвижение [4]. Н. Форсгрен, Д. Хамбл и Д. Ким относят непрерывную интеграцию и автоматизацию тестирования к практикам, связанным с более высокими показателями поставки программного обеспечения [7].
Цель статьи – обосновать состав CI/CD-конвейера с блокирующими проверками качества Python-кода, предложить порядок их введения на существующую кодовую базу и определить, где такой подход перестает себя оправдывать. Понятийной основой служит модель качества ГОСТ Р ИСО/МЭК 25010-2015, в которой надежность, защищенность и сопровождаемость выделены как самостоятельные характеристики качества программного продукта [2].
Объекты и методы исследования
Объектом исследования выступает процесс контроля качества кода в backend-разработке B2B-платформы компании Compel (ООО «РБА-менеджмент»), обслуживающей поиск и заказ электронных компонентов. Материал собран с августа 2024 по апрель 2026 года, когда автор работал в компании ведущим backend-разработчиком и техническим руководителем Python-разработки. Платформа включает несколько десятков взаимосвязанных микросервисов на Python и FastAPI, которые ежедневно обрабатывают тысячи запросов на поиск и заказ. Под руководством автора работали шесть backend-разработчиков; решения по сервисам автор принимал в составе архитектурного комитета.
Использованы включенное наблюдение, анализ конфигураций конвейера и практики рецензирования кода, сравнение полученного опыта с документацией инструментов и опубликованными исследованиями. Систематический учет дефектов в рассматриваемый период не велся, поэтому влияние проверок на дефектность описано качественно. Количественно зафиксирован один показатель – тестовое покрытие микросервисов. Покрытие измерялось инструментом pytest-cov (coverage.py) в CI-конвейере по строкам кода и рассчитывалось как доля исполненных тестами строк от общего числа строк всех микросервисов проекта, без учета миграций и автоматически сгенерированного кода. Начальное значение зафиксировано в августе 2024 года, конечное – в апреле 2026 года.
Результаты и их обсуждение
Рекомендательный и блокирующий режимы проверок
Одни и те же инструменты могут работать в двух режимах. В конфигурации разница между ними почти незаметна, но она меняет распределение ответственности за качество кода. В рекомендательном режиме решение по каждому предупреждению остается за человеком и при высокой нагрузке нередко принимается в пользу скорости. Quality gate не пропускает изменение дальше по конвейеру, пока нарушение не устранено, а требования записаны в конфигурации сервиса и применяются автоматически, независимо от автора изменения и ревьюера (табл. 1).
Таблица 1
Сравнение рекомендательного и блокирующего режимов проверок
Критерий | Рекомендательный режим | Блокирующий режим (quality gate) |
Результат проверки | Отчет с предупреждениями | Бинарный: проверка пройдена или не пройдена |
Последствие нарушения | Решение принимает разработчик или ревьюер | Слияние и развертывание невозможны |
От чего зависит качество | От дисциплины и внимательности конкретных людей | От правил, заданных в конфигурации |
Где зафиксированы требования | В договоренностях команды и документации | В конфигурации, хранящейся в репозитории сервиса |
Предмет рецензирования кода | Оформление, типовые ошибки, архитектура, логика | Архитектура, бизнес-логика, качество тестов |
Исключения из правил | Неявные, без учета | Явные, с указанием правила и причины |
Состав конвейера и назначение проверок
Технически блокировка реализуется штатными средствами GitLab CI/CD. Успешное завершение конвейера становится обязательным условием принятия запроса на слияние (merge request), а стадия развертывания запускается только после успешных стадий проверки. Схема конвейера показана ниже (рис. 1).
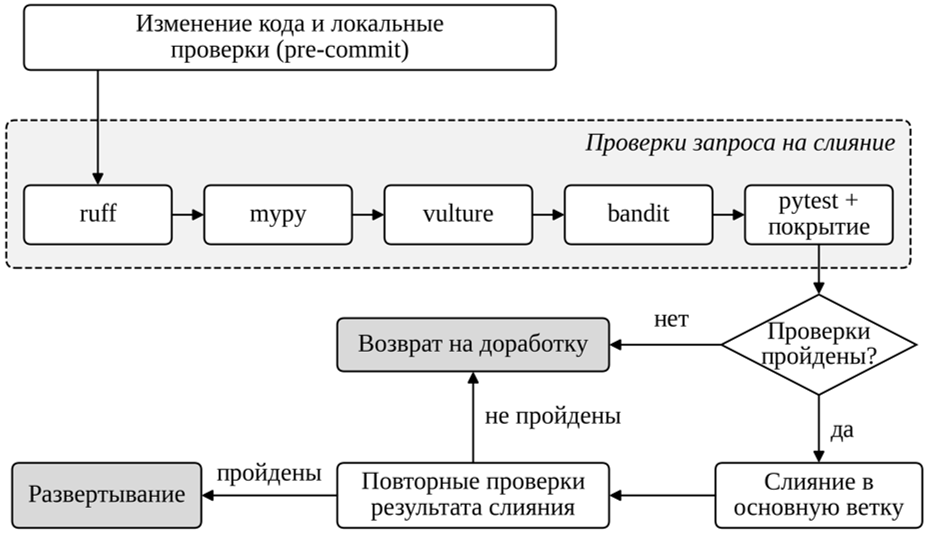
Рис. 1. Схема CI/CD-конвейера с блокирующими проверками качества
Проверки выполняются дважды. Первый прогон относится к запросу на слияние и не позволяет принять в основную ветку код с нарушениями. Второй выполняется на результате слияния перед развертыванием, поскольку несколько изменений, каждое из которых по отдельности прошло проверки, после объединения могут вступить в конфликт. Внутри прогона быстрые проверки идут первыми, автотесты – последними. Состав проверок, их связь с характеристиками качества по ГОСТ Р ИСО/МЭК 25010-2015 и условия блокировки приведены в таблице (табл. 2).
Таблица 2
Состав конвейера и условия блокировки
Инструмент | Что выявляет | Характеристика качества | Условие блокировки |
ruff | Нарушения стиля, неиспользуемые импорты и переменные, типовые логические ошибки | Сопровождаемость | Любое нарушение включенного набора правил |
mypy | Несоответствие типов, необработанные значения None, рассогласование кода с моделями данных самого сервиса | Надежность, сопровождаемость | Любая ошибка mypy при настройках, заданных для данного модуля |
vulture | Неиспользуемые функции, классы, атрибуты, недостижимый код | Сопровождаемость | Находка с уверенностью не ниже порога, не внесенная в белый список |
bandit | Вызов командной оболочки (shell=True) с динамически формируемой командой, небезопасную десериализацию, отключенную проверку TLS-сертификатов | Защищенность | Находка уровня medium или high, отсутствующая в базовой линии |
pytest с отчетом о покрытии | Регрессионные ошибки, снижение доли кода, исполняемого тестами | Надежность, сопровождаемость | Падение хотя бы одного теста или покрытие ниже порога |
Линтер ruff стоит в конвейере первым. Он проверяет крупный сервис за секунды и объединяет в одном инструменте правила, которые раньше приходилось настраивать в нескольких утилитах [12]. Конфигурация линтера хранится в репозитории, поэтому ее можно поддерживать единой для всех сервисов и снять с рецензирования споры об оформлении. Набор правил приходится подбирать осознанно. В эксперименте Д. М. Гиматдинова и соавторов линтеры общего назначения Pylint и Flake8 не дали ложных срабатываний, но обнаружили лишь около 22% нарушений из тестового набора, составленного под корпоративный стандарт кодирования [1, с. 48].
Для сервисов на FastAPI проверка типов особенно полезна. FastAPI и Pydantic строятся на подсказках типов, поэтому mypy (с плагином Pydantic) проверяет, что обработчики, бизнес-логика и клиенты сервиса согласованы с его моделями запросов, ответов и сообщений. Совместимость контрактов между разными сервисами mypy не гарантирует: он анализирует код одного репозитория, а схемы другого сервиса видит, только если они вынесены в общий пакет, и даже в этом случае проверяет код лишь относительно установленной в сервисе версии этого пакета. HTTP- и Kafka-контракты между сервисами проверяются отдельными средствами, например контрактными тестами или реестром схем.
Vulture находит код, оставшийся после удаления эндпоинтов, потребителей сообщений и интеграций. Неявного использования кода инструмент не видит, поэтому обработчики маршрутов FastAPI или поля моделей Pydantic могут ошибочно попадать в число неиспользуемых; для таких случаев предусмотрены порог уверенности, белый список и исключение функций с заданными декораторами [14].
Анализатор bandit проверяет синтаксическое дерево кода на известные небезопасные конструкции и присваивает каждой находке уровень серьезности [5]. Полноценного анализа защищенности он не заменяет. В конвейере блокируются находки уровня medium и high: вызов командной оболочки (shell=True) с динамически формируемой командой, небезопасная десериализация, отключенная проверка TLS-сертификатов. Секреты в коде bandit выявляет лишь по отдельным признакам, а соответствующие проверки паролей (B105–B107) имеют уровень low и при таком пороге конвейер не блокируют. Отдельная проверка на наличие секретов в конвейере не применялась.
Автотесты завершают конвейер. Блокирующими условиями служат падение любого теста и снижение покрытия ниже заданного порога. Порог покрытия – условие необходимое, но не достаточное. Л. Иноземцева и Р. Холмс показали, что при учете размера тестового набора связь между покрытием и способностью тестов находить ошибки оказывается от слабой до умеренной [8, с. 435]. Поэтому порог задает минимальный объем тестирования, а качество самих тестов по-прежнему оценивает ревьюер.
Порядок введения блокирующих правил на существующую кодовую базу
Основная трудность внедрения связана с уже написанным кодом. Если включить все проверки в полном объеме одновременно, унаследованные модули дадут сотни нарушений, конвейер будет завершаться ошибкой при любом изменении, и команде придется выбирать между остановкой поставки до полного погашения долга и отключением проверок. Ни один из вариантов не подходит. М. Физерс, описывая работу с унаследованным кодом, исходит из того, что изменения в нем нужно вносить небольшими шагами, под защитой проверок, фиксирующих уже работающее поведение [3]. Для quality gates из этого следует принцип храповика: число унаследованных нарушений может только уменьшаться, а любое ослабление правил (новое исключение, отключение правила) возможно только через явную процедуру согласования. Обобщение практики позволяет выделить пять этапов такого перехода (рис. 2).
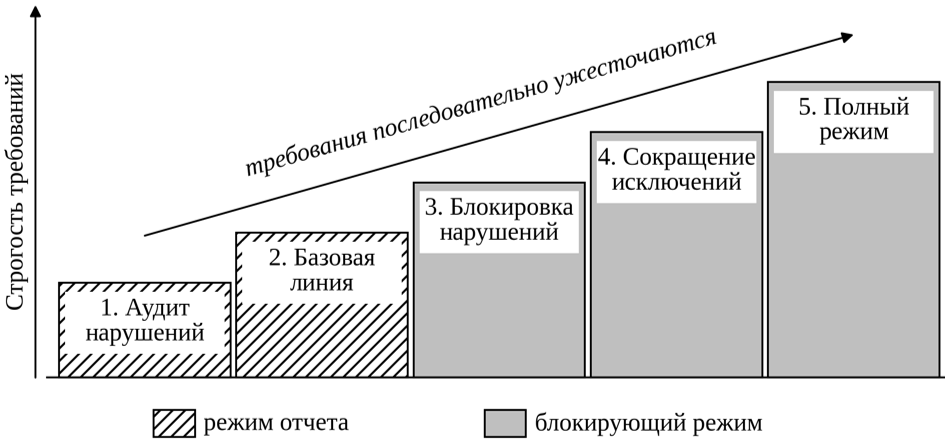
Рис. 2. Этапы введения блокирующих проверок на существующую кодовую базу
На этапе аудита инструменты запускаются в режиме отчета, чтобы оценить число нарушений и выбрать набор правил. Затем существующие нарушения фиксируются как базовая линия, а порог покрытия выставляется на фактическом уровне. С третьего этапа любое новое нарушение правил, действующих для данного модуля, блокирует конвейер. Список унаследованных исключений, зафиксированных в базовой линии, может только сокращаться: они убираются по мере работы с затронутыми модулями, а порог покрытия поднимается до каждого достигнутого значения. На пятом этапе унаследованных исключений не остается, и все модули проверяются по полному набору правил с учетом согласованных точечных исключений. Новое исключение допускается на любом этапе, но только по единой процедуре: с указанием кода правила, причиной и согласованием с техническим руководителем. Для такого перехода достаточно штатных средств самих инструментов (табл. 3).
Таблица 3
Штатные средства инструментов для поэтапного введения проверок
Инструмент | Штатное средство | Назначение при поэтапном введении |
bandit | Базовая линия: сохраненный отчет, с которым сравнивается новый результат | В отчет попадают только новые находки |
vulture | Белый список, порог уверенности, исключение функций с заданными декораторами | Отсекаются ложные срабатывания на неявно используемом коде |
ruff | Автоматическая расстановка комментариев-исключений, исключение конкретных правил для отдельных файлов | Существующие нарушения фиксируются без немедленного исправления |
mypy | Раздельные настройки проверок для отдельных модулей | Полный набор проверок для новых модулей, ослабленный для унаследованных |
pytest с отчетом о покрытии | Минимальный порог покрытия | Покрытие не может опуститься ниже порога, порог повышается поэтапно |
У такого перехода есть ограничение. Послабления задаются для модуля или файла целиком, поэтому новый код, добавленный в унаследованный модуль, проверяется по его ослабленным правилам. Закрыть этот разрыв можно двумя способами: переводить модуль на полный набор проверок при первой существенной доработке или контролировать замечания и покрытие только для измененных строк. В рассматриваемой практике модуль переводился на полный набор проверок при существенной доработке. Подавления без указания кода правила и полное отключение проверок для файла не допускаются, иначе список исключений превращается в канал обхода проверок.
Блокирующие проверки меняют привычный порядок работы, и команда нередко воспринимает их как замедление. Снизить сопротивление помогают две меры. Правила обсуждаются командой, а их конфигурация хранится в репозитории и меняется через то же рецензирование, что и код. Разработчик запускает те же проверки локально, например через pre-commit, и узнает о нарушении до отправки изменений.
У блокирующих проверок есть и управленческий эффект: замечание автоматической проверки не воспринимается как личная претензия ревьюера, а сам ревьюер может сосредоточиться на архитектуре, бизнес-логике и качестве тестов.
С августа 2024 по апрель 2026 года покрытие тестами микросервисов проекта выросло с 27 до 95% (рис. 3); порядок расчета показателя приведен в разделе «Объекты и методы исследования».
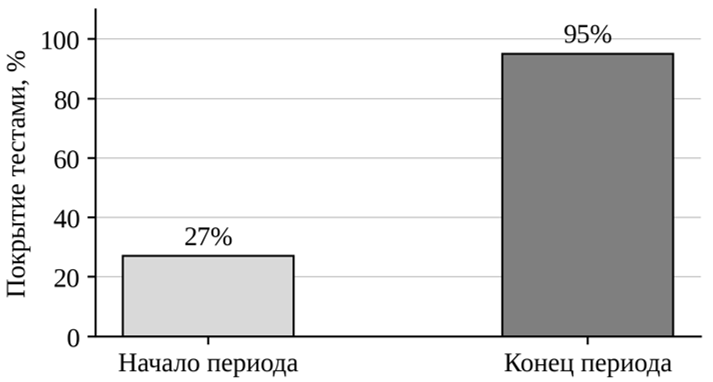
Рис. 3. Покрытие тестами микросервисов проекта в августе 2024 года и апреле 2026 года
Рост покрытия и внедрение quality gates шли параллельно; причинно-следственная связь между ними в работе не устанавливается. По наблюдениям автора, в период действия обязательных проверок дефектов стало меньше, а релизы стали стабильнее; систематических замеров этих показателей не проводилось.
Границы применимости блокирующих проверок
Блокирующие проверки полезны не везде, и избыточная жесткость способна снижать эффективность разработки. Основные ситуации такого рода и меры, позволяющие сохранить пользу проверок, сведены в таблицу (табл. 4).
Таблица 4
Ситуации, в которых блокирующие проверки снижают эффективность разработки
Ситуация | Риск | Компенсирующая мера |
Прототипы и исследовательский код | Строгие правила замедляют проверку гипотез, которые могут быть отброшены | Облегченный набор проверок для экспериментальных веток и полный при переносе кода в продукт |
Срочное исправление инцидента | Блокировка задерживает выпуск исправления | Задокументированная процедура обхода с последующим приведением кода к правилам |
Высокая доля ложных срабатываний | Механическое подавление предупреждений и потеря доверия к проверкам | Отключение правил с частыми ложными срабатываниями, пересмотр порогов уверенности |
Покрытие как самоцель | Тесты без содержательных проверок, написанные ради показателя | Рецензирование тестов, выборочное мутационное тестирование критичных модулей |
Длительный конвейер | Разработчики укрупняют изменения, обратная связь запаздывает | Параллельные стадии, кеширование зависимостей, порядок от быстрых проверок к медленным |
Небольшие утилиты и разовые скрипты | Затраты на настройку превышают пользу | Минимальный набор проверок: линтер и тесты |
Высокое покрытие само по себе не гарантирует способности тестов находить ошибки [8, с. 435], а обязательный порог создает соблазн писать тесты ради показателя. Важна и длительность конвейера: ценность непрерывной интеграции определяется скоростью обратной связи [4], и если проверки заметно увеличивают ожидание, разработчики начинают накапливать изменения. Наконец, статический анализ не выявляет ошибок бизнес-логики и архитектурных просчетов, поэтому quality gates не заменяют ни рецензирования кода, ни проектирования.
Заключение
Перевод проверок качества из рекомендательного режима в режим блокирующих правил CI/CD-конвейера меняет распределение ответственности за качество кода: соблюдение базовых требований обеспечивается автоматическим контуром, общим для всех сервисов системы. Для микросервисной Python-разработки на FastAPI оправдан набор из пяти проверок (ruff, mypy, vulture, bandit и автотесты с контролем покрытия), каждая из которых блокирует слияние и развертывание.
Вводить такие правила на существующую кодовую базу целесообразно поэтапно, по принципу храповика: от аудита нарушений и фиксации базовой линии к блокировке новых нарушений и постепенному сокращению унаследованных исключений. Этот порядок позволяет не останавливать поставку при большом объеме унаследованного кода.
Блокирующие проверки оправданы для долгоживущих продуктовых сервисов, но требуют облегченного режима для прототипов, процедуры обхода для срочных исправлений и контроля доли ложных срабатываний и длительности конвейера. Дальнейшее развитие работы связано с систематическим сбором метрик дефектности до и после внедрения quality gates.