Введение
Справочные помощники на основе больших языковых моделей обычно отвечают по предоставленному фрагменту текста: учебному материалу, документации или результату поиска. Трудность возникает, когда фрагмент близок к теме вопроса, но ответа не содержит. Модель в такой ситуации нередко не отказывается, а формирует правдоподобный ответ по соседним фактам текста или по собственным знаниям. Для учебного или корпоративного помощника такой ответ особенно вреден: пользователь видит ссылку на источник и не имеет причин сомневаться.
На практике применяют несколько простых мер. Модель просят отвечать только по тексту, требуют от неё подтверждающую цитату, программно проверяют, что цитата действительно есть в тексте, или отправляют готовый ответ на повторную проверку. Каждая следующая мера отсекает часть ошибочных ответов, но может отсечь и правильные, а также увеличивает число обращений к модели. Разработчику нужно знать, сколько ошибок устраняет каждая мера и какой ценой.
Цель работы – измерить на одних и тех же вопросах, как требование цитаты, проверка её дословности и самопроверка модели влияют на число ответов без опоры на текст, на число правильных ответов, а также на стоимость и время ответа. Сами методы известны; вклад работы состоит в их парном сравнении на двух моделях с раздельным учётом выигрыша и потерь.
Корпус SQuAD 2.0 содержит вопросы, специально составленные так, чтобы абзац был тематически близок к вопросу, но не содержал ответа [5, с. 784-789]. Это позволяет оценивать умение модели отказываться по готовой разметке, выполненной людьми. Чжоу и соавторы показали, что верность модели контексту существенно зависит от формулировки инструкции [8, с. 14544-14556]. В наборе ALCE правильность ответа и качество цитирования оцениваются раздельно [2, с. 6465-6488], а авторы UAEval4RAG подчёркивают, что отказ на вопросах без ответа нужно оценивать вместе с качеством ответов на обычные вопросы [4, с. 8452-8472].
Оценки самопроверки в литературе расходятся. Метод Chain-of-Verification снижает число галлюцинаций за счёт проверочных вопросов к собственному ответу [1, с. 3563-3578], тогда как Хуанг и соавторы показали, что без внешней информации модели плохо исправляют собственные рассуждения [3]. В настоящей работе используется более простой вариант: модель получает исходный абзац и готовый ответ и только разрешает или запрещает его выдачу. У такой проверки есть внешняя опора – сам абзац, поэтому её полезность заранее не очевидна и требует измерения.
Материалы и методы
Из development-части SQuAD 2.0 [5, с. 784-789; 6] отобрано 300 абзацев из 35 статей английской Википедии, по 8-9 абзацев на статью. К каждому абзацу взяты один вопрос, ответ на который в нём есть, и один вопрос, ответа на который в нём нет. Всего получено 600 вопросов, по 300 в каждой группе. Тексты и вопросы использованы без перевода и изменений; отбор выполнен случайно с фиксированным начальным значением генератора и не зависел от ответов моделей. До основного эксперимента проведён пробный запуск на 30 парах из training-части, не пересекающихся с основной выборкой.
Сравнивались четыре способа, каждый следующий добавляет одну меру к предыдущему:
- «Инструкция» – модель извлекает кратчайший ответ из абзаца либо явно сообщает, что ответа в нём нет;
- «Цитата» – модель дополнительно приводит дословную фразу из абзаца, подтверждающую ответ;
- «Дословность» – программа проверяет, что цитата точно содержится в абзаце, а ответ – в цитате, иначе ответ заменяется отказом;
- «Самопроверка» – ответ, прошедший проверку дословности, вместе с вопросом, абзацем и цитатой передаётся той же модели, которая решает, действительно ли абзац отвечает на вопрос. Проверка может только пропустить или отклонить ответ, но не исправить его.
Способы «Цитата», «Дословность» и «Самопроверка» используют один и тот же сгенерированный ответ, поэтому разница между «Самопроверкой» и «Дословностью» показывает эффект именно проверки при неизменном ответе. Это сравнение выбрано основным. Обе проверки могут только отклонять ответы, поэтому число выданных ответов при их добавлении не может вырасти; содержательный интерес представляет то, какие именно ответы отклоняются. Эталонные ответы и разметка корпуса модели не передавались.
Использованы модели DeepSeek-V4.1-Flash и Qwen3.6-35B-A3B, доступные через Yandex AI Studio, с температурой 0 и отключённым режимом рассуждений. Ответ запрашивался в формате JSON; ответы, не соответствующие формату, считались технической ошибкой и не засчитывались как отказ. Тексты запросов, выборка и правила анализа зафиксированы до основного запуска.
Для вопросов с ответом основной показатель – доля точных совпадений с эталоном (exact match, EM) после стандартной нормализации SQuAD; дополнительно приводится пословная F1-мера. Для вопросов без ответа основной показатель – доля случаев, когда модель всё же дала ответ (далее – ответы без опоры на текст). Система, которая всегда отказывается, имеет нулевую долю таких ответов, но и нулевую долю правильных, поэтому показатели рассматриваются только вместе. Для разностей между способами рассчитаны 95%-ные доверительные интервалы методом бутстрепа (10 000 повторений) с перевыборкой статей целиком, поскольку вопросы одной статьи не независимы. Стоимость рассчитана по фактическому числу токенов и тарифам Yandex AI Studio на 27.10.2026 с учётом НДС [7].
Результаты
Всего выполнено 3119 обращений к моделям: 2400 генераций ответов и 719 проверок; стоимость серии по тарифу составила 292,80 руб. Восемь ответов (семь у DeepSeek при способе «Цитата» и один у Qwen при «Инструкции») не соответствовали формату и учтены как ошибки. Результаты по всем способам приведены в таблице 1 и на рисунке.
Таблица 1
Качество ответов при разных способах проверки (из 300 вопросов каждой группы)
Модель, способ | Правильные ответы (EM) | F1, % | Ответы без опоры на текст | Ложные отказы |
DeepSeek, «Инструкция» | 212 (70,7%) | 86,4 | 53 (17,7%) | 8 (2,7%) |
DeepSeek, «Цитата» | 234 (78,0%) | 89,5 | 54 (18,0%) | 4 (1,3%) |
DeepSeek, «Дословность» | 232 (77,3%) | 88,9 | 54 (18,0%) | 6 (2,0%) |
DeepSeek, «Самопроверка» | 229 (76,3%) | 87,9 | 35 (11,7%) | 9 (3,0%) |
Qwen, «Инструкция» | 229 (76,3%) | 90,0 | 106 (35,3%) | 2 (0,7%) |
Qwen, «Цитата» | 245 (81,7%) | 92,5 | 94 (31,3%) | 3 (1,0%) |
Qwen, «Дословность» | 239 (79,7%) | 90,2 | 86 (28,7%) | 10 (3,3%) |
Qwen, «Самопроверка» | 225 (75,0%) | 85,2 | 23 (7,7%) | 28 (9,3%) |
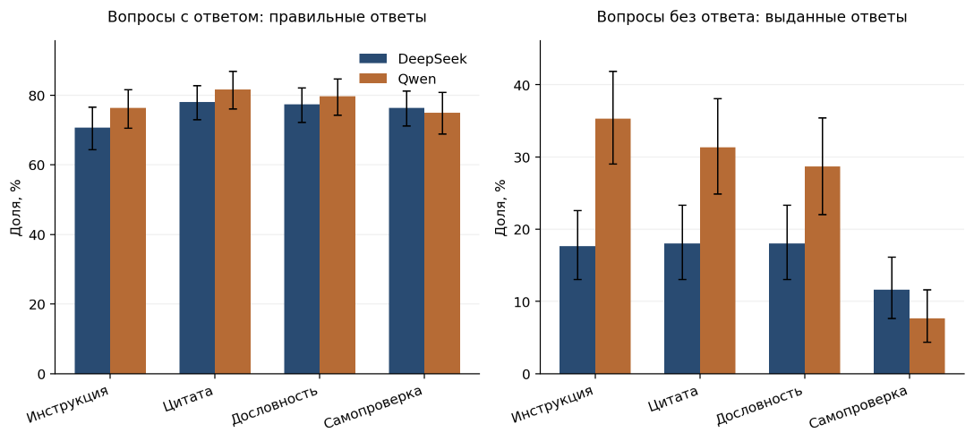
Рис. Доля правильных ответов на вопросы с ответом (слева) и доля ответов на вопросы без ответа (справа); отрезки – 95%-ные доверительные интервалы
Требование цитаты повысило точность на вопросах с ответом: у DeepSeek число правильных ответов выросло с 212 до 234, у Qwen – с 229 до 245. Однако на вопросы без ответа модели продолжали отвечать почти так же часто: 54 и 94 раза из 300. Проверка дословности ситуацию почти не изменила. У DeepSeek она не отклонила ни одного ответа без опоры на текст, у Qwen – 8 из 94, при этом из-за неточного цитирования было потеряно соответственно 2 и 6 правильных ответов.
Причину хорошо иллюстрирует пример из выборки. Вопрос касается даты пожара, уничтожившего в Джексонвилле 146 зданий, тогда как в абзаце говорится о 146 кварталах и более чем 2000 зданий. Qwen ответил «3 мая 1901 года» и привёл точную фразу из абзаца. Проверка дословности такой ответ пропускает: цитата подлинная, хотя относится к другому факту. Самопроверка этот ответ отклонила.
Основной результат – эффект самопроверки при неизменном ответе – приведён в таблице 2. Самопроверка сократила число ответов без опоры на текст у DeepSeek с 54 до 35, у Qwen – с 86 до 23. Платой стала потеря правильных ответов: у DeepSeek 3 из 232, у Qwen 14 из 239. Таким образом, DeepSeek отклонил 35% ответов без опоры и 1,3% правильных, а Qwen – 73% и 5,9% соответственно. Qwen проверяет строже: он отсекает больше ошибок, но и больше правильных ответов, поэтому лучшей по обоим критериям модели нет.
Таблица 2
Изменение показателей при добавлении цитаты и самопроверки, п. п. (в скобках – 95% доверительный интервал)
Модель | Добавленная мера | Ответы без опоры на текст | Правильные ответы (EM) |
DeepSeek | Цитата | +0,3 [−2,4; +3,3] | +7,3 [+3,7; +10,9] |
DeepSeek | Самопроверка | −6,3 [−9,7; −3,4] | −1,0 [−2,3; 0,0] |
Qwen | Цитата | −4,0 [−6,7; −1,0] | +5,3 [+2,6; +8,0] |
Qwen | Самопроверка | −21,0 [−27,0; −15,3] | −4,7 [−7,6; −2,0] |
Для самопроверки интервалы по доле ответов без опоры на текст не включают нуля у обеих моделей. Снижение точности у Qwen также устойчиво, а у DeepSeek оно мало и находится на границе интервала. Перевыборка пар абзацев вместо статей даёт близкие оценки: −6,3 [−9,0; −3,7] и −21,0 [−25,7; −16,3] п. п. Анализ носит разведочный характер, поправка на множественные сравнения не применялась.
Таблица 3
Стоимость и время ответа
Модель, способ | Стоимость, руб. за вопрос | Медиана времени, с | Обращений на вопрос | Доля правильных среди выданных, % |
DeepSeek, «Инструкция» | 0,1040 | 1,08 | 1,00 | 61,4 |
DeepSeek, «Дословность» | 0,1228 | 1,40 | 1,00 | 67,6 |
DeepSeek, «Самопроверка» | 0,1865 | 2,21 | 1,57 | 71,3 |
Qwen, «Инструкция» | 0,0682 | 0,49 | 1,00 | 56,7 |
Qwen, «Дословность» | 0,0828 | 0,57 | 1,00 | 63,6 |
Qwen, «Самопроверка» | 0,1294 | 0,98 | 1,63 | 76,3 |
Самопроверка требует второго обращения к модели примерно для 60% вопросов и увеличивает стоимость запроса на 52% у DeepSeek и на 56% у Qwen; медианное время ответа растёт с 1,40 до 2,21 с и с 0,57 до 0,98 с соответственно (табл. 3). Стоимость способа «Цитата» совпадает со стоимостью «Дословности», поскольку программная проверка не требует обращения к модели. Доля правильных среди выданных ответов при самопроверке растёт: с 67,6% до 71,3% у DeepSeek и с 63,6% до 76,3% у Qwen.
Обсуждение
Главное наблюдение состоит в том, что подлинная цитата ещё не означает, что текст отвечает на вопрос. Проверка дословности контролирует происхождение строки, но не её связь с вопросом, и на испытанном наборе она практически не снижала число ответов без опоры на текст. Если цель – отказ при недостаточном контексте, необходима проверка смысла, например самопроверка.
Полезность самопроверки зависит от того, как часто в реальном потоке встречаются вопросы без ответа. В таблице 4 приведён пересчёт на условный поток из 1000 запросов при доле таких вопросов 10% и 50% в предположении, что трудность вопросов внутри групп такая же, как в эксперименте. При доле 10% самопроверка Qwen предотвращает около 21 ответа без опоры на текст, но теряет около 42 правильных; при доле 50% соотношение меняется на 105 против 23. У DeepSeek потери меньше, но меньше и выигрыш. Дополнительные затраты выше при редких вопросах без ответа, поскольку повторная проверка выполняется только для выданных ответов, а их тогда больше.
Таблица 4
Изменение числа ответов при добавлении самопроверки на 1000 запросов
Модель | Доля вопросов без ответа, % | Правильные ответы | Ответы без опоры на текст | Дополнительные затраты, руб. |
DeepSeek | 10 | −9,0 | −6,3 | +97,43 |
DeepSeek | 50 | −5,0 | −31,7 | +63,69 |
Qwen | 10 | −42,0 | −21,0 | +66,74 |
Qwen | 50 | −23,3 | −105,0 | +46,55 |
Отсюда практический вывод: решение о включении самопроверки следует принимать по двум величинам – доле вопросов, на которые в базе знаний нет ответа, и допустимой потере правильных ответов. Для учебного помощника, где выдуманный ответ с видимой ссылкой на материал особенно вреден, самопроверка оправдана. Для сервиса, где почти все вопросы покрыты материалами, она может приносить больше потерь, чем пользы.
Результаты получены на коротких англоязычных абзацах Википедии и фактографических вопросах; перенос на русскоязычные учебные материалы и длинные документы требует отдельной проверки. Корпус SQuAD 2.0 публичен и мог встречаться моделям при обучении. Для каждой модели выполнен один прогон с одной формулировкой запросов. Показатель EM учитывает лишь совпадение строк и может занижать долю правильных ответов. Наконец, проверку выполняла та же модель, что и генерацию; проверка другой моделью может дать иной баланс.
Заключение
На 600 вопросах SQuAD 2.0 сопоставлены четыре способа ограничить ответы языковой модели предоставленным текстом. Требование цитаты повышает точность на вопросах с ответом, но вместе с проверкой дословности почти не помогает распознать вопросы без ответа. Самопроверка модели отклоняет от 35% до 73% ответов без опоры на текст, однако теряет от 1,3% до 5,9% правильных ответов и удорожает запрос примерно в полтора раза. Полученные оценки позволяют выбирать конфигурацию справочного помощника исходя из доли вопросов без ответа и допустимой потери полезных ответов. Дальнейшая работа предполагает проверку ответов другой моделью и испытание на русскоязычных учебных материалах.