Актуальность исследования
Актуальность исследования обусловлена быстрым развитием технологий искусственного интеллекта и расширением их применения в современных информационных системах. Наиболее распространенные модели, включая GPT, DeepSeek, Qwen, Claude и Gemini, способны решать широкий круг задач, связанных с обработкой текста, анализом данных, программированием, логическим рассуждением и работой с внешними инструментами.
При этом различные модели отличаются по функциональным возможностям, скорости работы, стоимости использования, объему контекста и способам интеграции. Поэтому использование одной модели для всех типов задач не всегда является оптимальным решением. Перспективным направлением становится совместное применение нескольких моделей искусственного интеллекта с распределением задач между ними в зависимости от требований конкретной информационной системы.
Таким образом, актуальность темы определяется необходимостью изучения подходов к интеграции различных моделей искусственного интеллекта, их сравнительной оценки и определения условий, при которых их совместное использование может способствовать повышению эффективности информационных систем.
Цель исследования
Целью данного исследования является анализ современных подходов к интеграции различных моделей искусственного интеллекта и определение возможностей их совместного использования для повышения эффективности информационных систем.
Материалы и методы исследования
Материалами исследования послужили официальная техническая документация разработчиков моделей искусственного интеллекта OpenAI, DeepSeek, Alibaba, Anthropic, Google и Mistral, а также документация Microsoft, Amazon Web Services, LiteLLM, LangChain и OpenRouter по вопросам интеграции, маршрутизации и взаимодействия моделей.
В работе использованы методы сравнительного анализа, систематизации и обобщения информации. Сопоставление моделей проводилось по их техническим характеристикам, поддерживаемым типам данных и возможностям интеграции. Для оценки практической эффективности мультимодельного подхода рассмотрены опубликованные результаты испытаний Amazon Bedrock Intelligent Prompt Routing.
Результаты исследования
Современные информационные системы все чаще используют большие языковые и мультимодальные модели искусственного интеллекта. К наиболее распространенным относятся модели OpenAI GPT, DeepSeek, Qwen, Claude, Gemini и Mistral. Они применяются для обработки и генерации текста, анализа документов, программирования, работы с изображениями и другими видами данных, а также для взаимодействия с внешними программными инструментами.
Прямое сравнение моделей только по одному показателю некорректно, поскольку они различаются по допустимым типам входных данных, длине контекста, объему выходных данных и набору встроенных средств. Поэтому для информационных систем практическое значение имеют прежде всего параметры, непосредственно указанные разработчиками в технической документации (таблица 1).
Таблица 1
Сравнительный анализ современных моделей искусственного интеллекта
| Модель | Контекстное окно | Максимальный вывод | Подтвержденные возможности |
| GPT-6 Astra | 1,05 млн токенов | 128 тыс. | текст и изображения, функции, веб-поиск, поиск по файлам, управление компьютером |
| DeepSeek V4 | 1 млн токенов | до 384 тыс. | режим рассуждения, JSON, вызов инструментов; V4.1 Flash поддерживает визуальные данные |
| Qwen3.8 Max | 1 млн токенов | 131 072 | текст, изображения, видео, функции, поиск, структурированный вывод |
| Claude Sonnet 5 | 1 млн токенов | 128 тыс. | адаптивное рассуждение, инструменты, агентные задачи |
| Gemini 3.8 Flash | 1 048 576 | 65 536 | текст, изображения, аудио, видео, PDF, функции, код, поиск |
| Mistral Medium 3.5 | 256 тыс. | – | мультимодальность, функции, структурированный вывод, Document Q&A, агенты |
Источник: составлено автором на основе официальной документации OpenAI, DeepSeek, Alibaba Cloud, Anthropic, Google и Mistral.
Сравнение показывает, что различия существуют не только в размере контекстного окна. Например, Gemini 3.8 Flash непосредственно поддерживает пять типов входных данных – текст, изображения, видео, аудио и PDF, тогда как OpenAI отдельно указывает текстовый и графический ввод для актуальных GPT-моделей. Qwen3.8 Max поддерживает изображения и видео, а DeepSeek-V4.1-Flash получил встроенное визуальное восприятие. Поэтому выбор модели в информационной системе зависит от фактического состава обрабатываемых данных, а не только от общей производительности модели [2].
Существенно отличаются и средства взаимодействия с внешней средой. OpenAI предоставляет функции, веб-поиск, поиск по файлам и управление компьютером; Gemini – выполнение кода, функции, поиск, работу с файлами и управление компьютером в предварительном режиме; Qwen поддерживает функции и встроенные инструменты; Mistral – функции, работу с документами и агентные интерфейсы. Эти различия непосредственно влияют на архитектуру информационной системы и перечень задач, которые могут выполняться без разработки дополнительных программных модулей [5].
На практике интеграция нескольких моделей может осуществляться через единый программный слой. Например, открытая платформа LiteLLM предоставляет единый формат обращения более чем к ста моделям разных поставщиков и преобразует запросы в формат соответствующего API. В ней предусмотрены повторные запросы, резервное переключение между моделями, балансировка нагрузки и учет затрат. Такой подход позволяет прикладной информационной системе обращаться к разным поставщикам через общий интерфейс вместо создания отдельного программного модуля для каждого API [3].
Другой подход основан на динамическом выборе модели для каждого запроса. В Semantic Kernel предусмотрена регистрация нескольких сервисов искусственного интеллекта и выбор нужного сервиса по его идентификатору либо по заданной разработчиком стратегии. Microsoft прямо приводит использование нескольких моделей как способ выбирать разные модели для разных запросов и управлять настройками их вызова [1].
Маршрутизация может осуществляться и на основании содержания запроса. В документации LangChain описана архитектура Router, при которой входной запрос классифицируется и направляется одному или нескольким специализированным исполнителям. При необходимости несколько исполнителей запускаются параллельно, после чего их результаты объединяются в общий ответ. LangGraph поддерживает параллельное выполнение ветвей по схеме fan-out/fan-in. Это дает техническую возможность распределять отдельные части одной задачи между разными моделями или специализированными агентами [8].
Еще один применяемый механизм – резервное переключение и балансировка. В OpenRouter можно задавать очередность поставщиков, разрешать резервные варианты и сортировать доступные варианты по задержке, пропускной способности или цене. Такие механизмы используются для продолжения обработки запроса при недоступности основного сервиса и для распределения нагрузки между несколькими доступными вариантами [7].
Архитектура мультимодельной интеллектуальной информационной системы строится на использовании нескольких моделей искусственного интеллекта в рамках единой программной среды. Запрос пользователя поступает в систему, после чего специальный модуль определяет подходящую модель с учетом типа задачи, доступных инструментов и установленных параметров маршрутизации. Такой принцип реализован, в частности, в Microsoft Foundry Model Router, где выбор модели осуществляется автоматически на основе содержания запроса и доступного набора моделей.
В состав системы могут входить пользовательский интерфейс, модуль маршрутизации, несколько моделей искусственного интеллекта, базы данных, внешние программные инструменты и средства контроля результатов. Общая схема взаимодействия этих компонентов представлена на рисунке ниже.
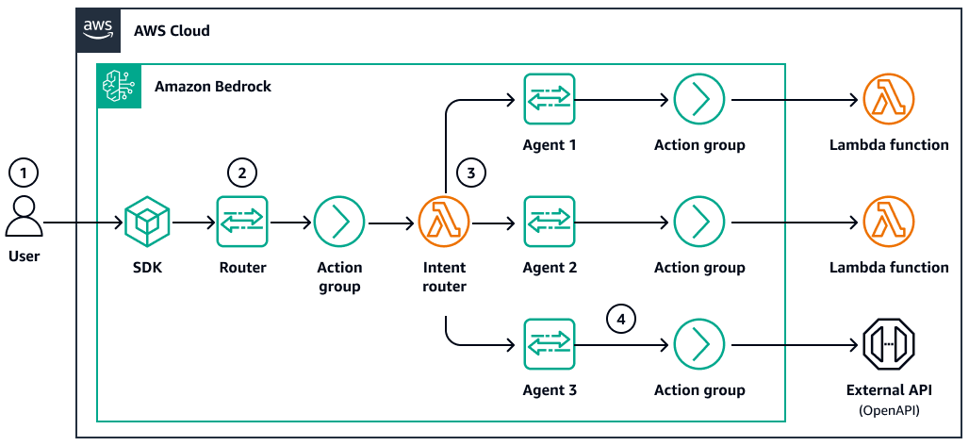
Рис. Общая архитектура мультимодельной интеллектуальной информационной системы [9]
Интеграция нескольких моделей искусственного интеллекта позволяет использовать различия в их функциональных возможностях в зависимости от характера решаемой задачи. Современные платформы маршрутизации поддерживают автоматический выбор модели, резервное переключение и управление соотношением между качеством результата и стоимостью обработки запроса. Основные преимущества такого подхода представлены в таблице 2.
Таблица 2
Основные преимущества интеграции различных моделей искусственного интеллекта
| Преимущество | Содержание |
| Рациональный выбор модели | Для разных типов запросов может использоваться модель, наиболее подходящая по своим возможностям и условиям применения |
| Оптимизация затрат | Простые запросы могут направляться менее ресурсоемким моделям, а более сложные – моделям с расширенными возможностями |
| Повышение устойчивости системы | При недоступности одной модели возможно резервное переключение на другую доступную модель |
| Гибкость информационной системы | Состав используемых моделей можно изменять в зависимости от требований системы и доступных сервисов |
| Снижение зависимости от одного поставщика | Использование нескольких моделей уменьшает технологическую привязку информационной системы к одному разработчику |
| Баланс качества и стоимости | Современные маршрутизаторы позволяют учитывать одновременно качество выполнения запроса и затраты на его обработку |
Источник: составлено на основе официальной документации [4] и [11]
Основное преимущество мультимодельной интеграции заключается в возможности гибко распределять запросы между доступными моделями с учетом требований к качеству, стоимости и устойчивости работы информационной системы.
Несмотря на преимущества использования нескольких моделей искусственного интеллекта, мультимодельная интеграция связана с рядом технических и организационных ограничений. Они обусловлены различиями между моделями, особенностями их программных интерфейсов, требованиями к обработке данных и необходимостью контролировать качество маршрутизации. Основные проблемы представлены в таблице 3.
Таблица 3
Основные проблемы и ограничения мультимодельной интеграции
| Проблема или ограничение | Содержание |
| Усложнение архитектуры системы | Использование нескольких моделей требует организации их взаимодействия, настройки маршрутизации и дополнительного контроля работы системы |
| Различия в программных интерфейсах | Модели разных разработчиков могут использовать различные форматы запросов, ответов и наборы поддерживаемых функций |
| Ограничения контекстного окна | При совместном использовании моделей необходимо учитывать ограничения той модели, которая имеет меньший допустимый объем контекста |
| Сложность тестирования | Автоматический выбор разных моделей увеличивает вариативность результатов и усложняет воспроизводимость тестов |
| Ограничения отдельных платформ | Некоторые маршрутизаторы поддерживают только определенные семейства моделей, языки, типы данных или режимы обработки |
| Необходимость постоянной оценки качества | После изменения состава моделей или правил маршрутизации требуется повторная проверка качества и корректности работы системы |
| Вопросы безопасности данных | При передаче запросов нескольким внешним сервисам необходимо учитывать требования к хранению, передаче и обработке информации |
Источник: составлено на основе официальной документации [4] и [11]
Следовательно, мультимодельная интеграция повышает гибкость информационной системы, но одновременно требует более сложного управления, регулярного тестирования и учета технических ограничений используемых моделей и платформ.
Эффективность системы, использующей несколько моделей искусственного интеллекта, целесообразно оценивать одновременно по качеству результата, стоимости обработки запросов и задержке ответа. Microsoft рекомендует проводить сравнение с базовой моделью на выборке не менее 100 запросов из реальной рабочей нагрузки, оценивать качество ответов по критериям точности, полноты, ясности и полезности, а задержку – по показателям p50, p90 и p95.
Практические результаты интеллектуальной маршрутизации опубликованы AWS. В проведенных компанией испытаниях маршрутизация позволила сохранить качество более производительной модели при снижении затрат, однако полученные значения зависят от состава запросов и используемых моделей (таблица 4).
Таблица 4
Результаты испытаний Amazon Bedrock Intelligent Prompt Routing
| Семейство моделей | Экономия затрат | Снижение задержки |
| Amazon Nova | 35 % | 9,98 % |
| Anthropic | 56 % | 6,15 % |
| Meta | 16 % | 9,38 % |
Источник: данные [10]
В отдельном испытании AWS на наборах данных RAG средняя экономия составила 63,6%, при этом 87% запросов направлялись модели Claude 3.5 Haiku, а качество ответов сохранялось на уровне базового использования Claude 3.5 Sonnet v2. AWS подчеркивает, что результаты конкретной информационной системы могут отличаться, поэтому эффективность маршрутизации необходимо проверять на собственных данных [10].
Перспективы развития интегрированных систем искусственного интеллекта связаны с переходом от использования одной модели к архитектурам, объединяющим несколько моделей, специализированных агентов, внешние инструменты и источники данных. Такой подход уже реализуется в современных платформах. Например, Microsoft Foundry позволяет использовать модели разных разработчиков, создавать многоагентные рабочие процессы, подключать инструменты и организовывать централизованный мониторинг работы системы [12].
Важным направлением является стандартизация взаимодействия отдельных компонентов. В современных агентных архитектурах используются Model Context Protocol (MCP) для подключения моделей и агентов к внешним инструментам и данным, а также Agent2Agent (A2A) для взаимодействия между агентами различных систем. Microsoft рекомендует использовать эти протоколы при построении распределенных многоагентных решений [6].
Одновременно развивается централизованное управление такими системами: отслеживание действий агентов, оценка качества их работы, управление доступом и политиками безопасности. Это позволяет рассматривать дальнейшее развитие интегрированных ИИ-систем как переход к управляемым многоагентным средам, в которых модели, инструменты и данные объединяются в рамках общей инфраструктуры.
Выводы
Проведенный анализ показывает, что совместное использование различных моделей искусственного интеллекта позволяет более гибко организовать работу информационной системы за счет распределения запросов в зависимости от особенностей задачи и возможностей конкретной модели. Практическая реализация такого подхода уже поддерживается средствами маршрутизации, балансировки нагрузки и резервного переключения. Вместе с тем мультимодельная интеграция усложняет архитектуру системы, повышает требования к тестированию, контролю качества и безопасности данных. Перспективы дальнейшего развития данного направления связаны с многоагентными архитектурами, стандартизацией взаимодействия между моделями, агентами, внешними инструментами и источниками данных.


