В современных коммерческих организациях значительная часть операционной деятельности связана с подготовкой типовых юридических документов: договоров поставки, заявлений, служебных записок, коммерческих предложений. В ООО «ГЛАВХОЗТОРГ», осуществляющем оптовые поставки строительных материалов и санитарно-технического оборудования, ежемесячно формируется около 600 договоров на поставку товара. При ручной подготовке одного договора затрачивается 15–20 минут, что создаёт существенную нагрузку на сотрудников и повышает риск ошибок при переносе реквизитов контрагентов [1, с. 413-435].
Существующие средства автоматизации документооборота ориентированы либо на распознавание текста без его семантического анализа, либо на диалоговые системы без генерации готовых документов. Большинство решений не поддерживают мультимодальный ввод и не адаптированы под русскоязычные юридические документы. Так, движок Tesseract обеспечивает точность распознавания до 95–98% на качественных изображениях, однако при наличии шумов и теней она существенно снижается [4, с. 629-633; 10]. Коммерческие OCR-системы (ABBYY FineReader, Google Cloud Vision) показывают более высокие результаты, но требуют передачи данных на сторонние серверы, что не всегда допустимо с точки зрения информационной безопасности.
В последние годы для задач извлечения структурированных данных из неструктурированного текста активно применяются большие языковые модели (LLM). Систематический обзор их применения в legal domain приведён в [1, с. 413-435], отдельные аспекты юридической NLP рассматриваются в [2]. Среди доступных на российском рынке решений выделяются GigaChat и YandexGPT. GigaChat поддерживает механизм function calling и структурированный вывод в формате JSON [8], что открывает возможности для использования LLM в задачах автоматической генерации документов. Промышленные кейсы совместного применения OCR и GigaChat для извлечения реквизитов описаны в [9]. Вместе с тем, как показал анализ литературы, гибридные подходы, объединяющие OCR, LLM и мультимодальный ввод для генерации юридических документов на русском языке, изучены недостаточно. Отдельные мультимодальные фреймворки документооборота предложены в [5, с. 14359-14360; 6], однако они не ориентированы на русскоязычные юридические документы и, как правило, не поддерживают голосовой ввод.
Цель работы – разработка и экспериментальная проверка мультимодальной интеллектуальной системы генерации типовых юридических документов, обеспечивающей извлечение реквизитов из текстовых и голосовых запросов, а также фотографий, и автоматическое заполнение шаблонов DOCX.
Для достижения цели поставлены следующие задачи:
- Проанализировать существующие подходы к автоматизации подготовки юридических документов и обосновать выбор технологий распознавания речи, оптического распознавания текста, извлечения структурированных данных и генерации документов.
- Разработать архитектуру мультимодальной системы, объединяющей модуль диалога, модуль распознавания речи, модуль OCR, модуль извлечения реквизитов на основе большой языковой модели и модуль генерации документов.
- Реализовать прототип системы в виде Telegram-бота с многошаговым сценарием на основе конечных автоматов и резервным механизмом извлечения реквизитов на основе регулярных выражений.
- Провести экспериментальную оценку точности извлечения ключевых реквизитов на выборке карточек организаций различных организационно-правовых форм.
- Оценить практический эффект внедрения системы в коммерческой организации по критериям сокращения времени подготовки документов и снижения числа ошибок при переносе реквизитов.
Научно-техническая гипотеза исследования: гибридный подход, объединяющий предобработку изображений, OCR, извлечение реквизитов большой языковой моделью с постобработкой на основе регулярных выражений и резервный regex-парсер, обеспечивает точность извлечения ключевых реквизитов не менее 95% на уровне отдельных полей и не менее 90 % на уровне документов, а также сокращает время подготовки типового договора не менее чем на 90% по сравнению с ручной подготовкой.
Критерии проверки гипотезы:
- точность извлечения реквизитов на уровне полей – не менее 95%;
- доля документов, обработанных без ошибок, – не менее 90%;
- сокращение времени подготовки документа – не менее 90%;
- сохранение работоспособности при недоступности GigaChat API за счёт резервного парсера (проверяется сценарием отказа).
Предлагаемая система реализована в виде Telegram-бота и включает пять ключевых модулей: модуль диалога, модуль распознавания речи, модуль оптического распознавания текста, модуль извлечения реквизитов на основе GigaChat и модуль генерации документов. Общая архитектура системы представлена на рисунке 1.
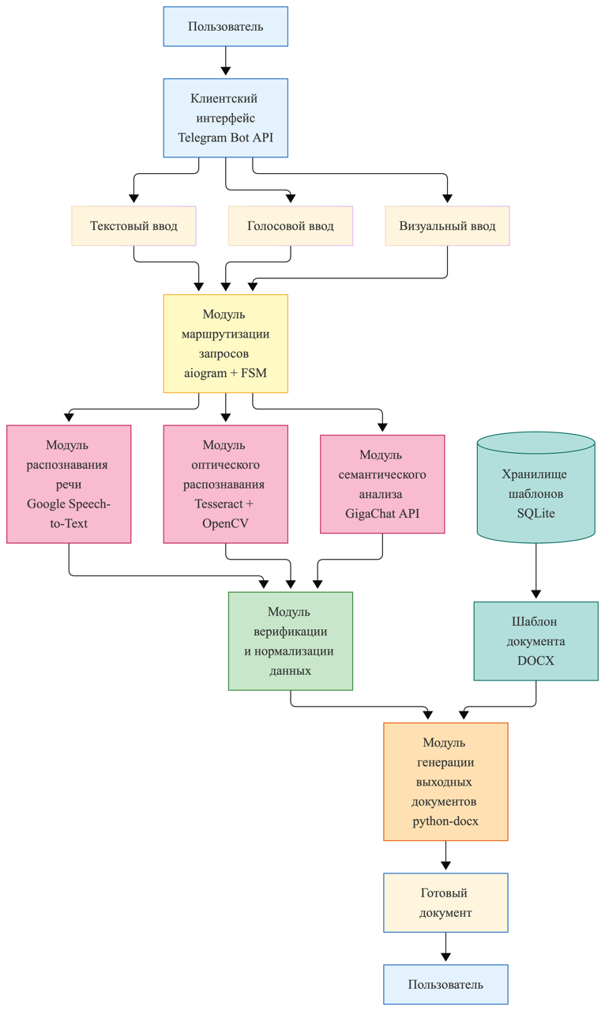
Рис. 1. Архитектура мультимодальной интеллектуальной системы
Модуль диалога реализован с использованием библиотеки aiogram и обеспечивает взаимодействие пользователя с системой. Поддерживаются три канала ввода: текстовый запрос, голосовое сообщение и фотография реквизитов. Бот последовательно проводит пользователя по четырём шагам и на каждом этапе запрашивает один параметр, что снижает риск ошибки при вводе и делает процесс наглядным. Внешний вид диалога с ботом представлен на рисунке 2.
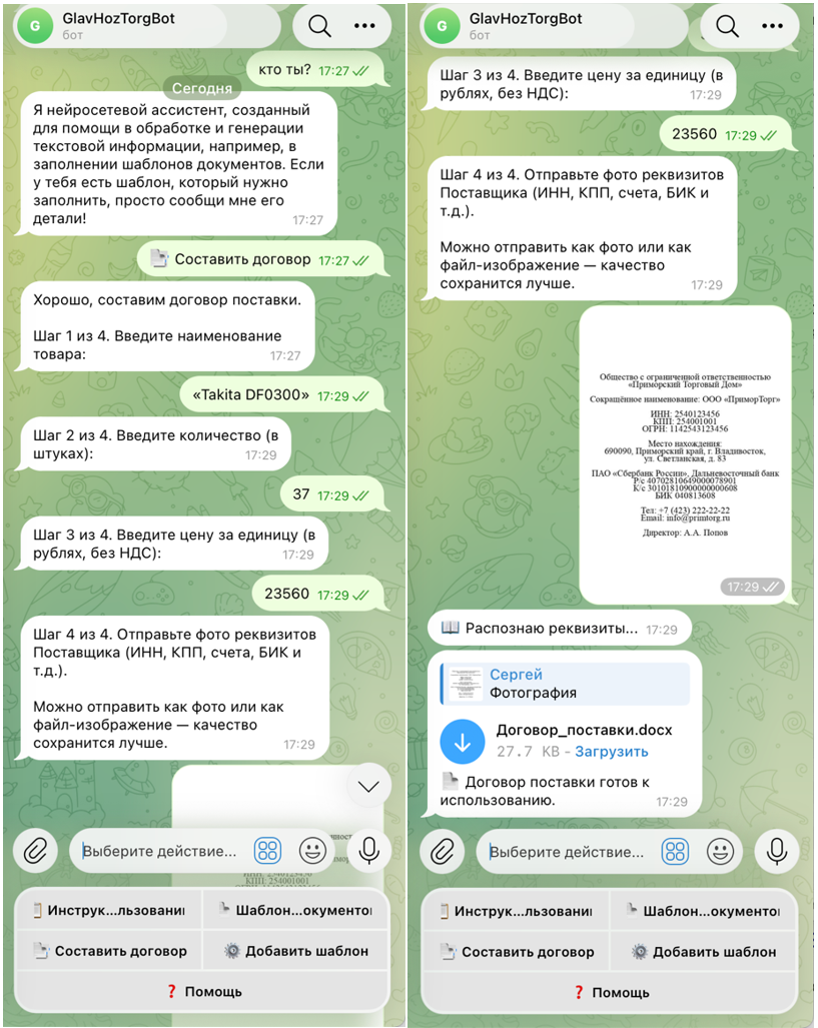
Рис. 2. Пример диалога пользователя с Telegram-ботом при составлении договора
Для сценария составления договора поставки применён механизм конечных автоматов (Finite State Machine, FSM), встроенный в библиотеку aiogram. Диалог разбит на четыре последовательных состояния: ввод наименования товара, количества, цены за единицу и ожидание фотографии реквизитов контрагента. На каждом шаге система сохраняет введённые пользователем данные в хранилище состояний (MemoryStorage) и переходит в следующее состояние только после получения корректного ответа. Это исключает потерю данных при длительном диалоге и позволяет пользователю в любой момент прервать сценарий командой /cancel. После получения фотографии реквизитов все накопленные данные извлекаются из хранилища и передаются в модуль генерации документа.
Модуль распознавания речи основан на сервисе Google Speech-to-Text. Голосовое сообщение скачивается из Telegram в формате OGG, конвертируется в WAV с помощью FFmpeg и передаётся в сервис распознавания. Полученный текст направляется в модуль извлечения реквизитов. Теоретические основы обработки речи и диалоговых систем изложены в [7].
Модуль оптического распознавания текста выполняет предобработку изображений с использованием библиотеки OpenCV: увеличение разрешения, выравнивание контраста методом CLAHE, бинаризацию методом Оцу и медианную фильтрацию шумов. Обработанное изображение передаётся в Tesseract OCR с русским языком [4, с. 629-633]. Предобработка позволяет повысить точность распознавания даже на фотографиях с неравномерным освещением и тенями; влияние шумов на качество вывода Tesseract и способы его снижения описаны в [10].
Модуль извлечения реквизитов использует большую языковую модель GigaChat. Задача извлечения реквизитов относится к классу legal NER; для русского языка создан датасет RuLegalNER [3, с. 854-857], однако он ориентирован на судебные решения, а не на карточки организаций. Распознанный текст отправляется в модель с детальным промптом, задающим структуру извлекаемых данных в формате JSON [8]. Промышленный опыт аналогичной интеграции OCR и GigaChat описан в [9].
Для повышения отказоустойчивости системы реализован резервный механизм извлечения реквизитов на основе регулярных выражений, используемый при недоступности GigaChat API или при возврате моделью некорректного ответа. Резервный парсер извлекает ИНН, КПП, ОГРН/ОГРНИП, расчётный и корреспондентский счета, БИК, адреса электронной почты и телефоны непосредственно из распознанного текста. Счета определяются по явным меткам «Р/с» и «К/с» с учётом возможных ошибок OCR, что обеспечивает корректное распределение даже при нестандартном форматировании документа. Использование резервного парсера позволяет системе сохранять работоспособность в условиях сетевых сбоев и ограничений на доступ к внешним сервисам.
Модуль генерации документов на основе библиотеки python-docx открывает заранее подготовленный шаблон договора поставки в формате DOCX и выполняет замену плейсхолдеров вида {{name}}, {{inn}}, {{rs}} на извлечённые значения. Реализован обход как обычных параграфов, так и таблиц, что позволяет корректно заполнять реквизиты сторон и спецификацию товара. Шаблоны документов хранятся в базе данных SQLite вместе с описанием их переменных, что позволяет добавлять новые типы документов без изменения программного кода – достаточно загрузить подготовленный шаблон в формате DOCX с разметкой переменных вида {{name}}. Для шаблонов, размеченных в базе данных, GigaChat автоматически подбирает подходящий документ по запросу пользователя.
Разработанная система имеет модульную архитектуру, взаимодействие между пользователем и системой, представлено в таблице 1.
Таблица 1
Компоненты системы и используемые технологии
Этап/компонент | Назначение | Технологии |
| 1. Пользователь | Отправляет фото реквизитов + параметры товара | – |
| 2. Telegram-бот (FSM) | Ведёт диалог, собирает параметры товара | Aiogram 3 (FSM) |
| 3. Модуль OCR | Извлекает текст из изображения с предобработкой | Tesseract OCR, OpenCV |
| 4. Модуль LegalParser | Извлекает реквизиты, валидирует | GigaChat API |
| 5. Модуль ContractBuilder | Сопоставляет извлечённые поля с переменными шаблона | Python |
| 6. Модуль CreateDocuments | Подставляет переменные в DOCX-шаблон | python-docx |
| 7. Telegram-бот (отправка) | Отправляет пользователю готовый договор | Aiogram 3 |
| 8. Хранилище (опционально) | Сохраняет историю генераций | SQLite |
Для проверки работоспособности системы подготовлена выборка из 30 тестовых карточек предприятий (25 ЮЛ и 5 ИП). Каждая карточка содержит полный набор полей: наименование, ИНН, КПП (для ЮЛ), ОГРН/ОГРНИП, адрес, счета, БИК, телефон, email, директор. Результаты тестирования отражены в таблице 2.
Таблица 2
Точность по типам полей
Поле | Верно/всего | Точность |
Название | 30/30 | 100% |
ИНН | 30/30 | 100% |
КПП | 25/25 | 100% |
ОГРН/ОГРНИП | 30/30 | 100% |
Адрес | 30/30 | 100% |
Р/с | 30/30 | 100% |
К/с | 30/30 | 100% |
БИК | 30/30 | 100% |
Телефон | 29/30 | 96.7% |
29/30 | 96.7% | |
Директор | 30/30 | 100% |
Средняя точность извлечения реквизитов на уровне полей составила 99,4% (323 корректных значения из 325 проверяемых; КПП оценивался только для 25 ЮЛ). Полностью без ошибок обработаны 28 из 30 карточек (93,3%). Наиболее устойчиво система извлекает ИНН, КПП, ОГРН/ОГРНИП, банковские счета, БИК, адрес и ФИО руководителя – по этим полям ошибок не зафиксировано. Обе ошибки относятся к полям «телефон» и «email» и вызваны распознаванием символов OCR в коротких текстовых строках (например, сочетание «ru» распознано как «mu» в адресе электронной почты). Символьные ошибки в коротких полях не компенсируются контекстом LLM, поскольку модель получает уже искажённый текст. Данный класс ошибок устраним на этапе предобработки изображений или последующей валидации формата email и телефона.
Таким образом, выдвинутая гипотеза подтверждена: точность по полям составила 99,4% (порог – 95%), доля документов без ошибок – 93,3% (порог – 90%), время подготовки документа сократилось более чем на 90% (порог – 90%). Работоспособность при недоступности GigaChat API обеспечивается резервным regex-парсером.
Практическая значимость системы подтверждена её внедрением в ООО «ГЛАВХОЗТОРГ». Время подготовки одного договора поставки сократилось с 15–20 минут до 10–20 секунд, что при объёме около 600 документов в месяц соответствует экономии порядка 150–200 часов рабочего времени ежемесячно. Указанная оценка не учитывает время на проверку сгенерированного документа сотрудником и относится к верхней границе эффекта. Дополнительно снижено количество ошибок при переносе реквизитов контрагентов за счёт автоматического заполнения шаблона.
Передача данных во внешние сервисы (Google Speech-to-Text, GigaChat API [8]) создаёт зависимость от сетевой доступности и требует отдельного анализа с точки зрения защиты информации. Сравнение с альтернативными конфигурациями (OCR + регулярные выражения без LLM) в работе не проводилось; существующие мультимодальные фреймворки [5, с. 14359-14360; 6] также не предоставляют готового baseline для русскоязычных юридических документов.
В работе предложена и реализована мультимодальная интеллектуальная система генерации типовых юридических документов, объединяющая текстовый, голосовой и визуальный каналы ввода. Система реализована в виде Telegram-бота на основе aiogram с многошаговым сценарием на конечных автоматах и включает модули распознавания речи (Google Speech-to-Text), оптического распознавания текста (Tesseract OCR с предобработкой OpenCV), извлечения реквизитов на основе GigaChat с постобработкой регулярными выражениями, резервный regex-парсер и модуль генерации DOCX на основе python-docx.
Экспериментальная проверка на 30 карточках организаций показала точность извлечения реквизитов 99,4% на уровне полей и 93,3% на уровне документов. Внедрение системы в ООО «ГЛАВХОЗТОРГ» сократило время подготовки договора поставки с 15–20 минут до 10–20 секунд.
Дальнейшее развитие предполагает добавление валидации ИНН и ОГРН по контрольной сумме, поддержку PDF-документов, интеграцию с корпоративной информационной системой предприятия, а также количественную оценку голосового канала и сравнительный анализ альтернативных конфигураций.